Hirolia
インド・ネパール系飲食店向け モバイルオーダーSaaS
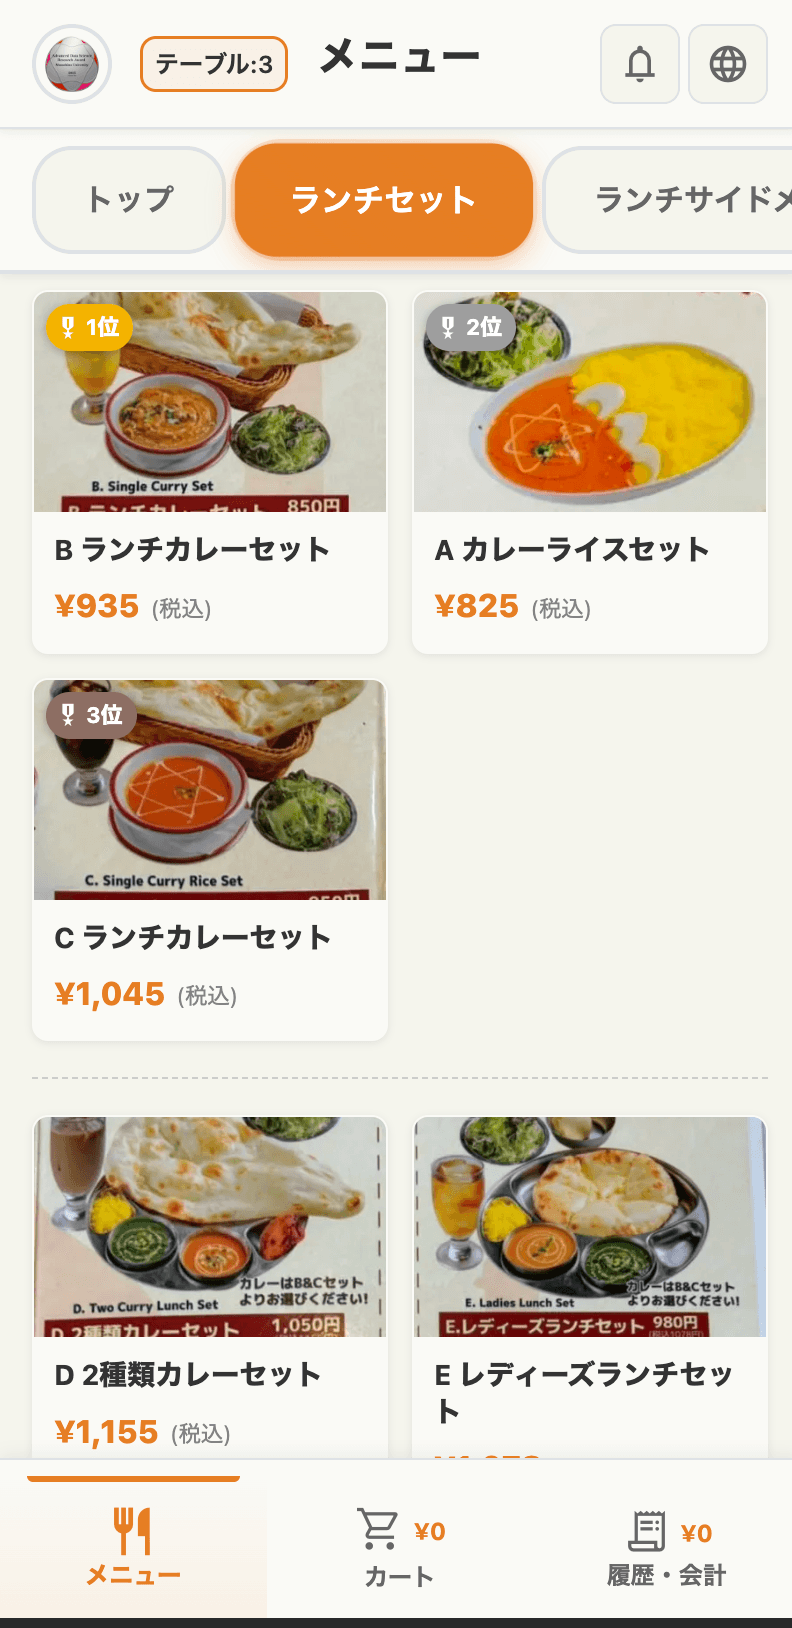
インド・ネパール系の飲食店向けのモバイルオーダーSaaSです。来店客が自分の端末からメニューを見て注文し、店舗側は管理画面からメニューや店舗ごとの設定を管理します。
5人チームで、事業・営業担当が3名、エンジニアが2名。自分はエンジニア2名のうちの1人として、顧客向け注文画面・メニュー管理画面・Backend API・DB設計を担当し、実店舗への導入後は本番環境の運用も担当しています。
- プロダクト
- 飲食店向けモバイルオーダーSaaS
- チーム
- 5人(事業・営業3名 / エンジニア2名)
- 自分の役割
- エンジニア2名のうち1人
- 期間
- 2025年11月 要件定義・仕様整理・設計開始 / 12月 実装開始 〜 現在
- 導入状況
- 本契約4店舗(2026年9月時点)
背景と課題
Hirolia を入れる前の店舗で起きていたのは、言語だけの問題ではなく、注文のやりとりが特定の人に依存していたことでした。
- 日本語で注文対応ができる人に、業務が集中する
- 口頭でのやりとりなので、聞き間違いが起きる
- 「言った・言わない」が発生する
- 注文内容の確認に手間がかかる
- 問題が起きたときに、誰の確認漏れだったのかが曖昧になる
この整理は、開発を始めた時点で自分がすべて把握できていたものではありません。事業担当から聞いた話を出発点に、店舗へ導入して運用する中で輪郭がはっきりしてきたものです。
担当範囲
担当した
- 顧客向け注文画面の実装
- メニュー管理画面の実装
- Backend API の実装
- DB設計
- 店舗別設定 / 一部のマルチテナント対応
- Render 本番環境の構築・運用
- Better Stack によるエラー監視・外形監視(Slack へ通知)
- GitHub Actions による CI(pytest の自動実行)
- PostgreSQL の外部バックアップ(pg_dump)
- 本番障害対応
担当していない
- Service Worker / PWA 基盤の設計・実装(もう1人のエンジニアの担当)
- 店舗開拓・契約・店舗との折衝(事業・営業担当3名)
- メニュー内容そのものの決定(店舗側)
導入後に出た問題
開発環境では動いていた
手元とステージングでは、想定した操作をすれば想定どおりに動いていた。
店舗へ導入した
実際の店舗の回線・端末・メニュー・オペレーションの上で動かすことになった。
現場固有の問題が出た
店舗Wi-Fiの不安定さ、来店客の端末差、想定より複雑な実メニュー、セッションの扱い、更新が端末に反映されない、といった問題が出た。
問題ごとに、事実を確認 → 原因候補を切り分け → 直す、を繰り返した。仕様そのものを変えた判断もある。
判断と実装
メニュー・セット・多言語を扱うデータ構造
- 何が問題だったか
- プロトタイプでは「商品が並んでいる」前提のデータ構造だった。実店舗のメニューはセット商品、トッピング、辛さの選択、同じ商品の表記ゆれなどを含んでいて、そのままでは表現できなかった。多言語の表示も必要だった。
- どう判断して、どう実装したか
- 店舗の実メニューを見ながら、どこまでをデータ構造で表現し、どこからを店舗側の運用で吸収してもらうかの線を引き直した。すべてをシステムで表現しようとせず、管理画面から店舗が編集できる範囲を決めてDB設計をやり直した。
- いまどうなっているか
- 店舗ごとに違うメニューを、店舗側が管理画面から登録できる範囲が広がった。一方で、最初にメニューの実物を見ずにデータ構造を決めたことが、後の作り直しの原因だったと考えている。
セッション / 複数端末 / 状態管理 / 更新の反映
- 何が問題だったか
- 来店客が自分の端末で注文するため、端末もブラウザもバラバラだった。注文の状態がどの端末にどう保持されるか、同じ卓で複数端末から注文されたときにどうなるか、アプリを更新しても古い状態が残り続けるケースがあるか、といった問題が導入後に出た。
- どう判断して、どう実装したか
- 自分の担当範囲(セッションの持ち方、API側の状態の扱い、注文の確定タイミング)を中心に、どの状態をサーバー側の真実とするかを決め直した。Service Worker / PWA 基盤そのものはもう1人のエンジニアの担当のため、更新の反映まわりは切り分けた事実を共有して一緒に対応した。
- いまどうなっているか
- 端末側に状態を持たせすぎないほうが、現場では壊れにくいと分かった。再現しにくい問題は、推測で直さず、まず再現条件を確定させるほうが速いという感覚がついた。
本番運用:監視・CI・バックアップ・障害対応
- 何が問題だったか
- 実店舗の営業時間中に落ちると、そのまま店舗の業務が止まる。最初は「落ちたことに気づくのが、店舗からの連絡」という状態だった。
- どう判断して、どう実装したか
- Better Stack でエラー監視と外形監視を入れ、異常を Slack へ通知して、落ちたことにこちらが先に気づける状態にした。GitHub Actions で pytest を通してから反映する流れにし、PostgreSQL は pg_dump で外部へバックアップを取るようにした。障害が起きたときは、まず店舗が営業を続けられる状態に戻すことを優先した。
- いまどうなっているか
- 「動くものを作る」から「落ちたときに気づいて戻せるようにする」へ、自分の担当範囲が広がった。まだ手動に頼っている部分も残っていて、整備の途中。
現在の状況
- 2025年11月
- 要件定義・仕様整理・設計開始
- 2025年12月
- 実装開始
- 2026年4月
- 1店舗目へ試験導入
- 2026年7月
- 1店舗目が正式な有料契約へ移行
- 2026年9月
- 本契約4店舗で運用中
確定していること
- 本契約4店舗(2026年9月時点)
- 実店舗で継続して利用されている
現場からの反応(計測はしていない)
- 営業メンバーを通じて、「注文対応が楽になった」という反応が共有された
- 口頭でのやりとりが減った
これらは営業メンバー経由で共有された反応と、現場での観察にもとづくものです。客単価や回転率などは計測していないため、検証済みの成果としては書いていません。
学び
「技術的に動くもの」と「現場で使われ続けるもの」は違う。
開発環境で動いたときに感じる「できた」と、店舗で1ヶ月使われ続けたときの「使えている」は、まったく別のものでした。この差を埋める作業のほとんどは、新しい機能を足すことではなく、現場を見て、前提を揃えて、直すことでした。
- 使う人が実際にどう動くかを、想像ではなく現場で確認する
- 作って終わりにせず、運用に乗ってからの状態まで見る
- 届いた反応を、直す手がかりとして受け取る
- 関係者の前提がずれていないかを先に揃える
- 壊れたときに戻せる状態を用意しておく
実装・運用・切り分け・改善は、Hirolia で実際に担当してきた範囲です。一方で課題設定・優先順位づけ・提案は、これから伸ばしたいところです。
使用技術
- Python / Flask(Backend API)
- PostgreSQL(本番DB / DB設計)
- Render(本番環境)
- GitHub Actions(CI / pytest の自動実行)
- Better Stack(エラー監視 / 外形監視 → Slack 通知)
- pg_dump(PostgreSQL の外部バックアップ)
技術の選定そのものより、これを実店舗の営業時間中に動かし続けることの方に時間を使っています。